一秒输出400+字,我让小米OCR本地模型速度翻了3倍 | 已被官方收录
Xiaomi-OCR-0 的 NInfer 本地推理适配、双显卡性能测试、实际识别效果与部署方法。
OCR 是法律行业一个非常常见的工作流程
对方发的证据/案卷都是扫描件不好查找文本,需要OCR
下载的论文、判决书是图片不好看,需要OCR
发给LLM看,不想外挂一个VLM,需要OCR
尤其刑事阅卷,保密需求大,本地OCR是刚需
恰好,OCR模型恰好是本地模型的甜点区,参数不高,硬件需求低,跑起来速度也不慢
恰好,最近几个月各家模型厂商也在卷了一下OCR模型
又恰好,小米开源了一个OCR模型,根据他们的评测,达到了行业领先水平
又又恰好,最近有个叫Ninfer的Nvidia Blackwell专用后端非常火
所以,我做了一点小工作
让 Xiaomi-OCR-0 模型
无损提升了3倍速度
* 本文仅为笔者个人观点,不视为任何法律建议。
一、为什么是Xiaomi-OCR-0?
SeerRay-Lab是小米旗下的开源模型实验室,最近开源了一些模型,其中包括了Xiaomi-OCR-0
至于为什么选Xiaomi-OCR-0
首先,无广
其次,主要根据小米的报告,这个模型分数排名还是比较高的,尤其Real5-OmniDocBench排第一,这个榜基于扫描、页面变形、屏幕翻拍、光照变化、倾斜五种条件下进行测试,非常贴合我们日常工作情况(为什么这么多人喜欢屏摄和歪着拍照)
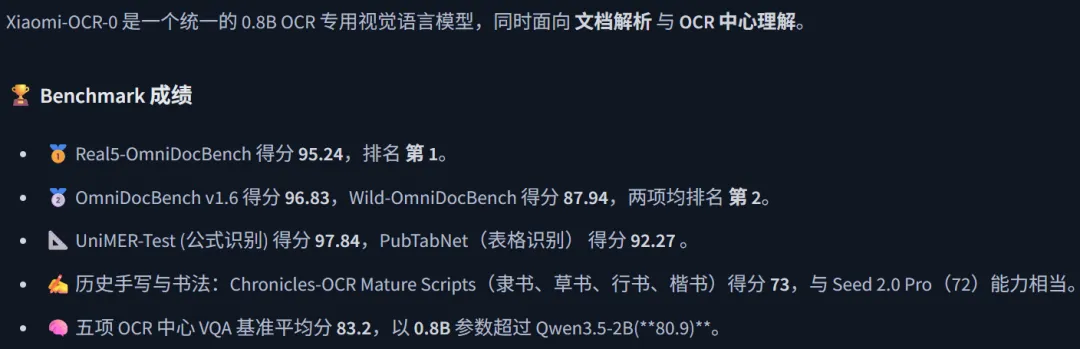
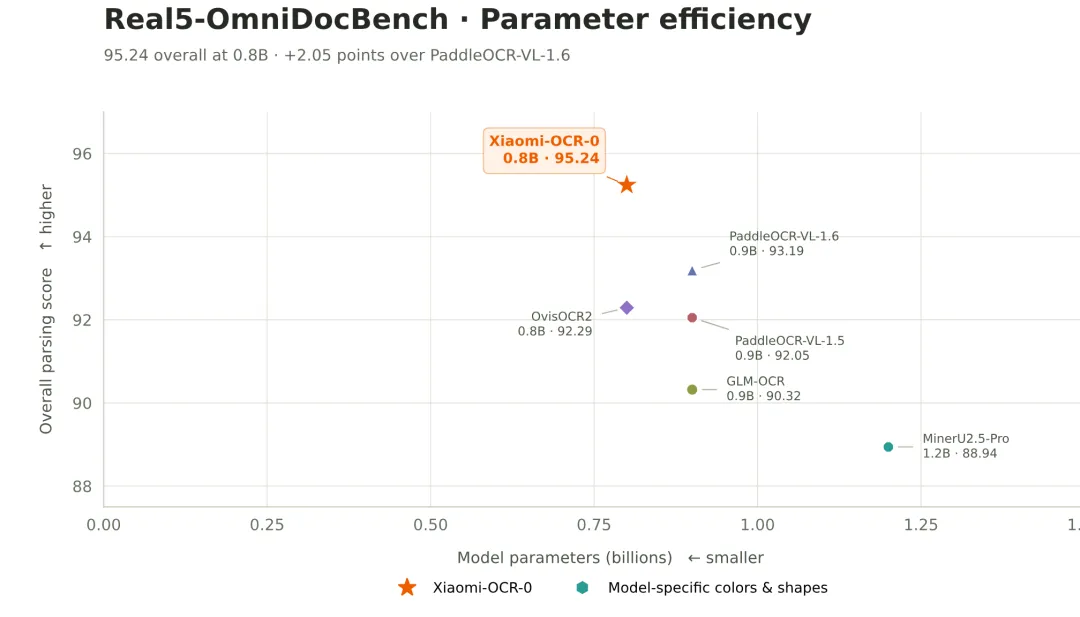
功能上支持文档解析、OCR 相关问答和关键信息提取,非常实用
再者,这个模型基于Qwen3.5-0.8B-Base后训练,参数小,意味着推理快,需要的配置低,而且最重要的是
Qwen3.5!
二、为什么用Ninfer?
Ninfer是最近很火的NVIDIA Blackwell(俗称50系)专用推理后端
特点是快,超级快
比ollama、llama.cpp、vLLM、SGLang都快得多
缺点是目前只支持 Qwen 系列模型,官方只兼容5090,且只有限支持某几个模型
所以拿来推理Xiaomi-OCR-0,等于
没有缺点
兼容性?
只要有Token,就等于没有兼容性问题
三、Xiaomi-OCR-0-Ninfer 实际效果
所以,我先把小米官方模型转成了Ninfer版本
然后,因为官方不兼容Qwen 3.5,所以通过一(亿)点点调优:
例如,补齐了模型对应的计算形状、门控计算、视觉位置编码和中文分词
例如,把视觉投影、偏置、残差和激活中能合并的操作融合起来,减少中间结果来回写入、读取;针对小批量推理调整计算安排,再用 CUDA Graph 减少重复启动计算的开销。融合时也保留了需要的舍入步骤,并做数值检查,避免只顾快、悄悄改了计算结果
例如,读取图片和提示词的阶段,还做了分块处理适配等等
成功把模型在我的Ninfer Extended版里面跑起来
最终优化结果
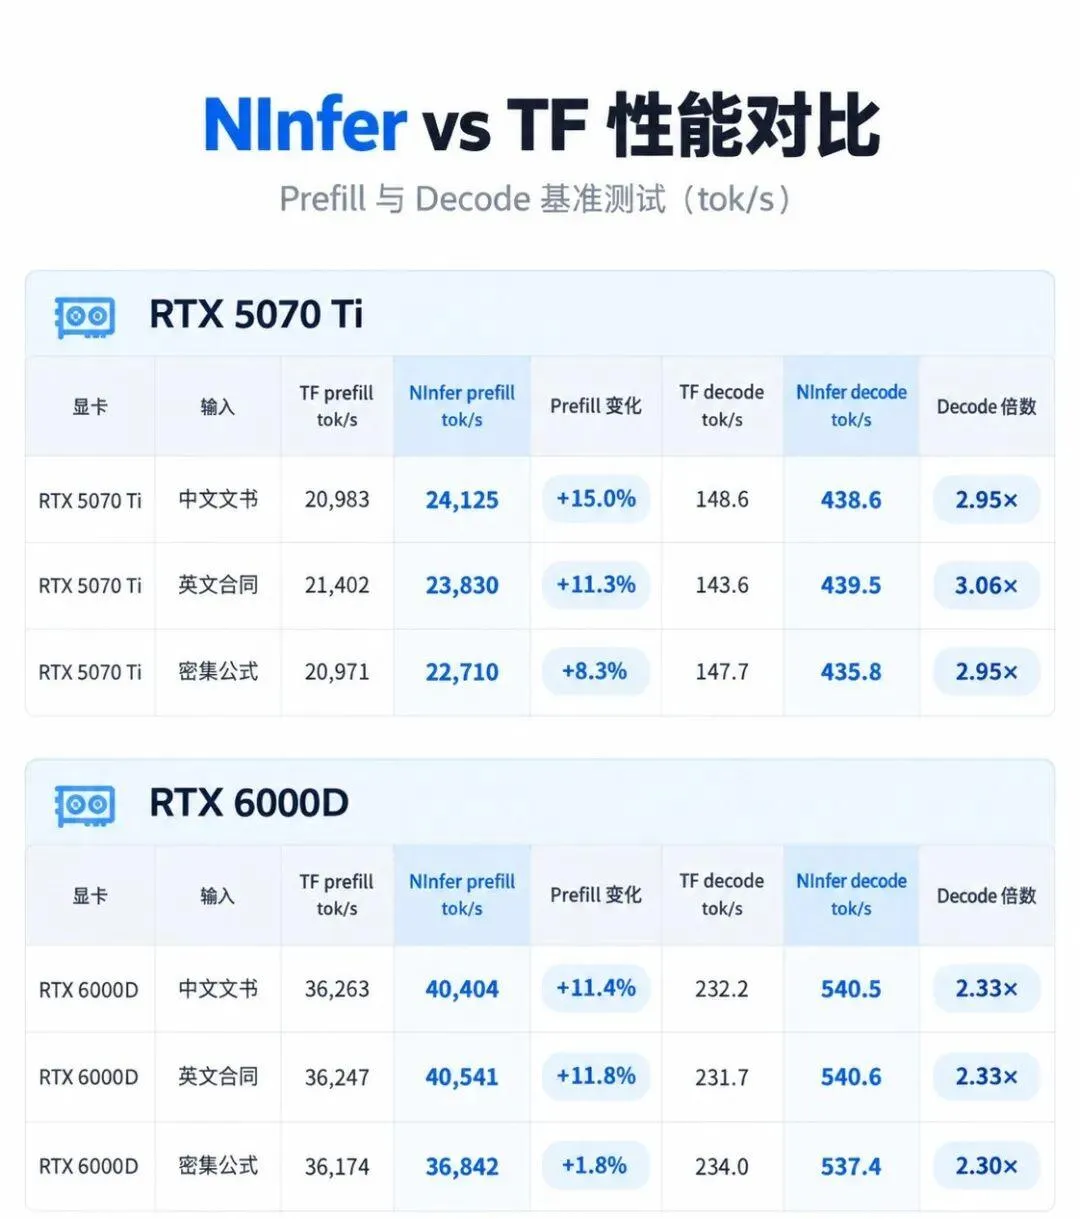
* TF = 用Transformer推理原生BF16模型
在速度最多提升3倍的基础上,正确率完全一致,和原生BF16模型没有任何差异
| 显卡 | Transformers 字符正确率 | NInfer 字符正确率 | 原始输出一致率 | 字符差异率 |
|---|---|---|---|---|
| RTX 5070 Ti | 100%(CER 0%) | 100%(CER 0%) | 3/3(100%) | 0% |
| RTX 6000D | 100%(CER 0%) | 100%(CER 0%) | 3/3(100%) | 0% |
如果这样看起来不够直观,那还能看看实测
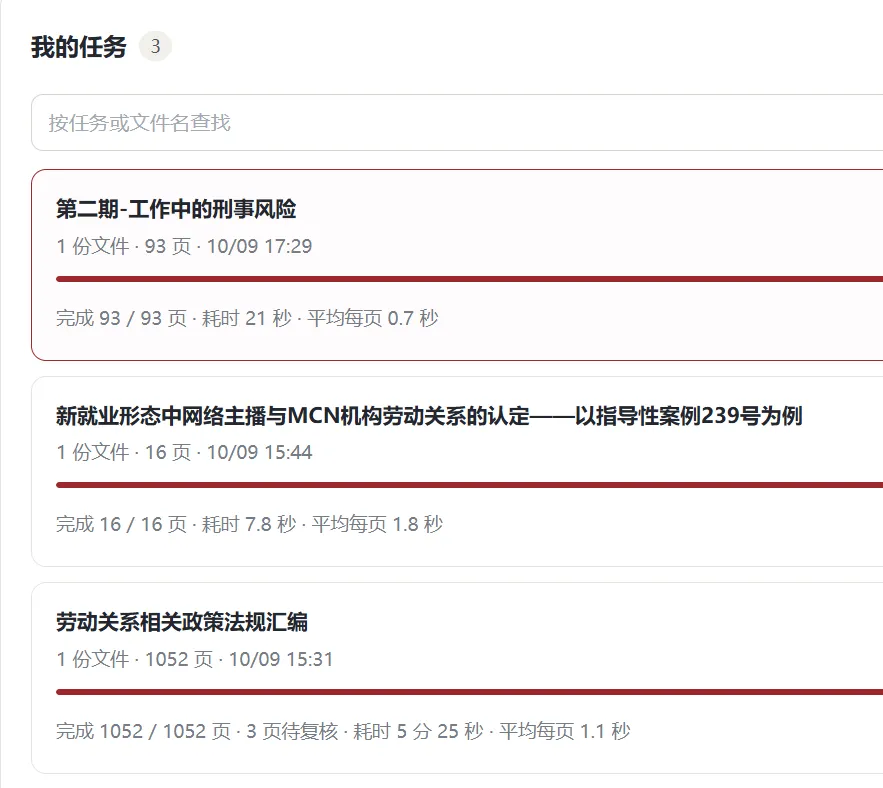
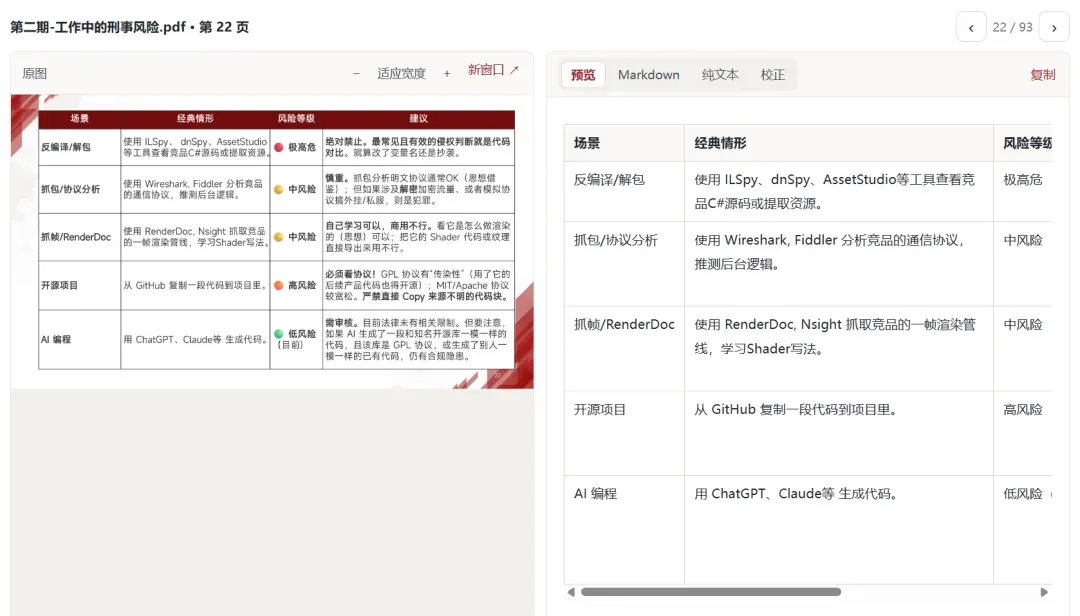
PPT转录,平均每页0.7秒
论文转录,平均每页1.8秒
法律汇编,平均每页1.1秒
表格,正常识别输出
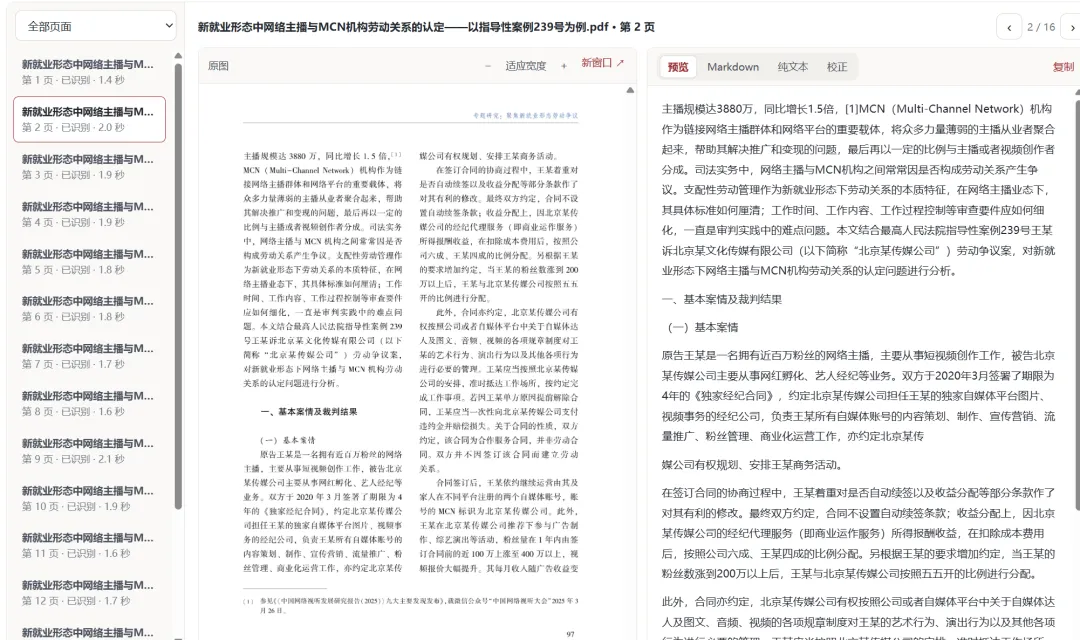
1126个字符且分为双栏,2秒完成正确解析和输出
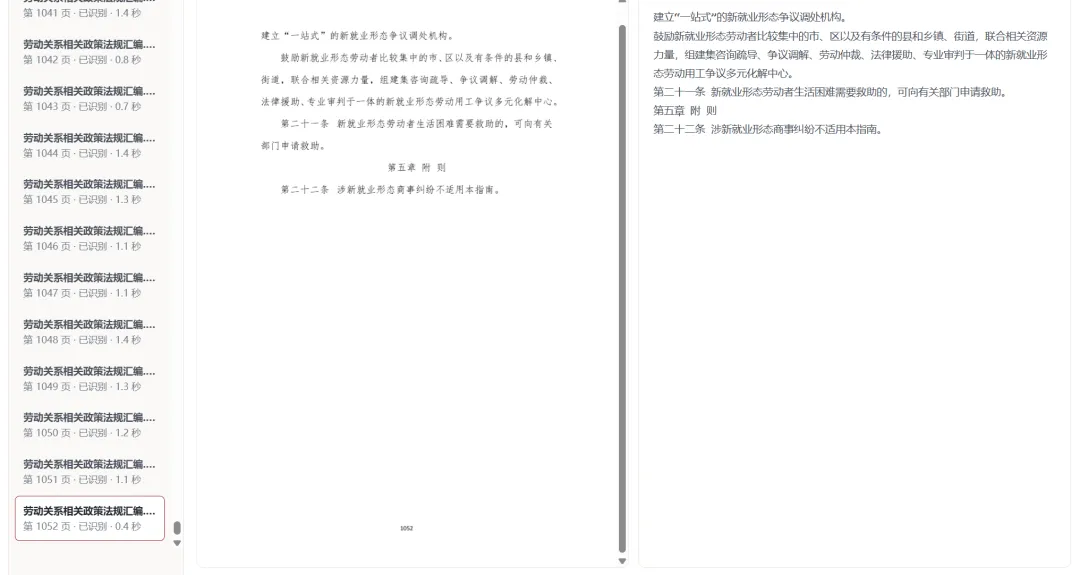
1052页法律汇编,不到5分半完成
基本已经满足日常工作需要
四、Xiaomi-OCR-0-Ninfer怎么用?
有50系显卡的朋友,把这句话发给各位的Agent即可
请帮我在本地部署ByronLeeee/Xiaomi-OCR-0-Ninfer模型,依据modelscope页面中的说明文档完成构建,并根据我现有的硬件情况进行算子适配优化。
目前已在5070Ti和6000D上完成了适配优化
至于其他显卡,尤其Mac用户,估计要自己适配优化了
(注意,上面演示这个WebUI工具不包含在仓库内,这次只发布了模型和推理后端)
五、最后
感谢小米官方收录
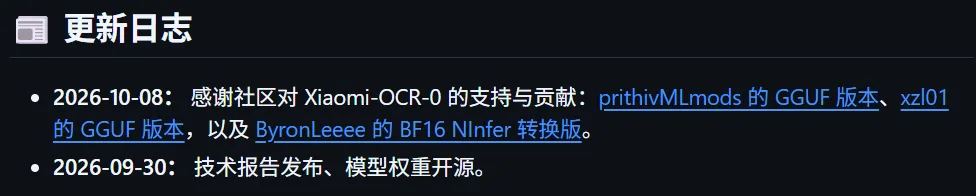
就个人而言
比起各种前端软件
还是实打实的数字提升更令人兴奋
现在就等Qwen4-27B发布了
作者简介
李伯阳律师
北京市隆安(广州)律师事务所高级合伙人、隆安湾区人工智能法律研究中心主任,《法律人ChatGPT应用指南》作者,Word/WPS AI插件 WordOllama 作者。 具有十余年互联网法律实务经验,曾先后为创业板上市互联网企业、全国互联网综合实力50强企业、互联网快时尚零售独角兽等提供法律服务。擅长办理互联网类企业诉讼与合规业务,擅于通过计算机技术手段深度挖掘证据。
引用本文
李伯阳:《一秒输出400+字,我让小米OCR本地模型速度翻了3倍 | 已被官方收录》,李伯阳律师网站,2026年10月9日,https://www.lslby.com/research/xiaomi-ocr-ninfer-local-speedup/